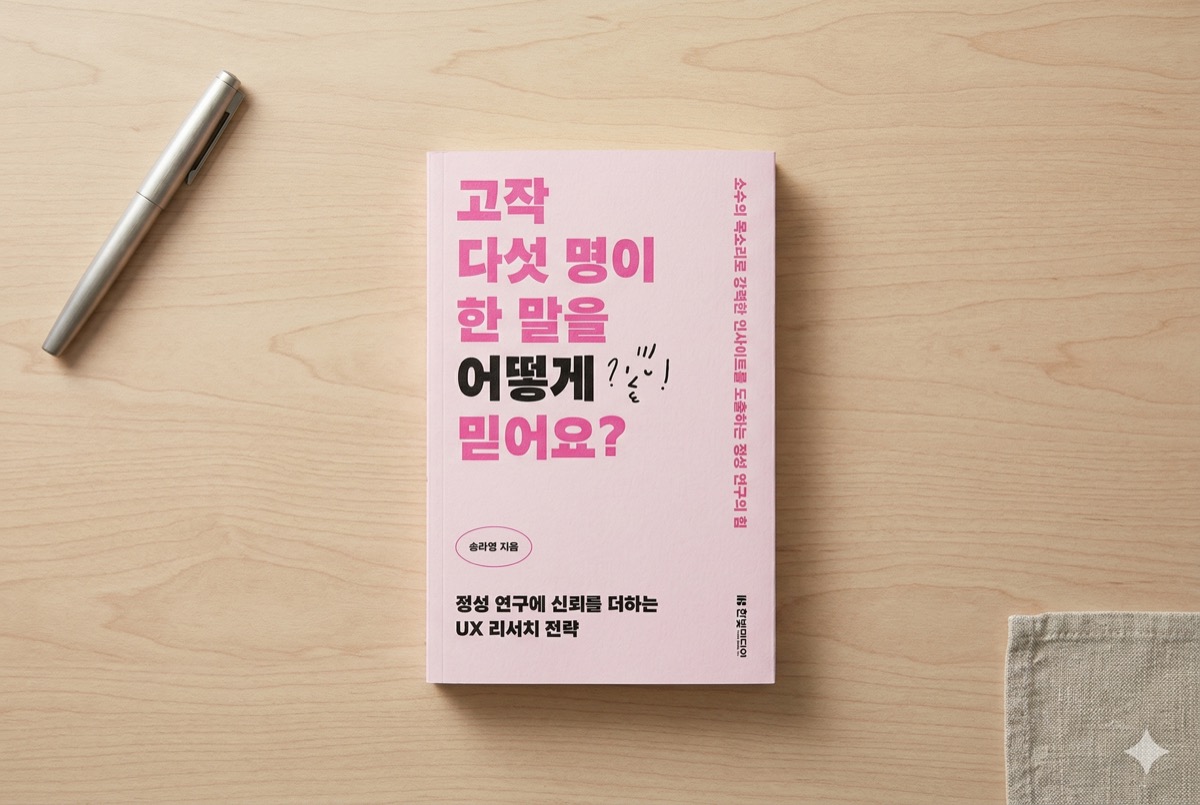
고작 다섯 명이 한 말을 어떻게 믿어요?
송라영의 '고작 다섯 명이 한 말을 어떻게 믿어요?'를 읽고
개발자였던 제가 PM이 되면서, '자 이제 무슨 기능을 만들어보지?' 라는 질문을 하게 되었습니다. 사실 이 회사에 3년간 있으면서 느낀 것은 많은 동료들이 저마다의 아이디어를 가지고 있다는 것입니다. 제 머릿속에도 많은 아이디어가 있었어요. 하지만 무엇이 정말 고객을 위한 기능인지, 어떤 기능을 만들면 임팩트가 있을지 확신이 서지 않았습니다.
물론, 저희도 고객들이 웹사이트를 어떻게 탐색하는지 확인하기 위한 데이터를 수집하고 있습니다. 하지만 여기에는 고객이 무엇을 했다는 있지만, 왜 그런 행동을 했는지에 대해서는 알 수 없습니다. 저는 여기에 갑갑함을 느끼고 다른 방법은 없을까 클로드와 대화를 나누던 중에 이 책을 추천받았습니다.
제가 이 책을 통해 알고 싶었던 것은 정량적 데이터와 비교했을 때 정성적 데이터는 무엇인지? 이것을 통해서 얻을 수 있는 것은 무엇인지? 어떻게 적용할 수 있는지? 였습니다. 이런 궁금증을 가지고 읽던 중 인상 깊었던 내용을 정리해보려고 합니다.
1. 데이터를 수집하는 이유
데이터를 수집하는 이유에 대한 내용이 인상 깊었습니다.
우리는 '세상을 설명할 수 있다'고 믿는 데이터를 모읍니다. 정량 연구는 숫자를 통해 세상을 설명하고 현상을 표현할 수 있다고 가정합니다. (중략) 한편 정성 연구는 말과 글을 통해 세상을 설명할 수 있다고 가정합니다. p.40
너무 당연한 말입니다만, 데이터를 수집하는 이유는 '무언가를 설명하기 위함'입니다. 만약 무언가를 설명하려는 목적 없이 데이터를 수집한다면, 그것은 유의미한 데이터를 수집했다고 볼 수 없습니다. 저는 이런 기초적인 마인드셋을 배울 수 있었습니다.
2. 정성 연구의 목표
정성 연구는 개개인의 생각과 감정을 연구하는 방법이기 때문에 연구 결과의 일반화를 목표로 하지 않습니다. (중략) 정량 연구는 연구 결과의 일반화를 목표로 하는 반면, 정성 연구는 이전 가능성(transferability)을 목표로 합니다. 즉, 비슷한 특징을 가진 5명의 참여자가 그리는 현실이 비슷하고 그들이 겪는 문제점에 유사한 패턴이 있다면, 이 5명과 같은 특징을 가진 다른 유저 그룹에게 적용 가능한 유의미한 결과가 된다는 뜻입니다. p.65
비슷한 특징을 가진 집단을 잘 분류합니다. 그리고 그 중에서 5명을 선정하여 인터뷰를 진행합니다. 이때 그들에게 나타나는 유사한 패턴이 있다면, 나머지 사람들에게도 비슷한 패턴이 나타날 것이라고 추론할 수 있다는 것입니다.
정량적 데이터를 논할 때, 팀원과 항상 '모수가 너무 부족하잖아'라는 말을 자주했습니다. 마찬가지로 정성적 데이터도 표본이 너무 부족한데, 어떻게 신뢰할 수 있는지 의문이 들었습니다. 하지만 이 책을 읽고 나니, 정성적 데이터는 '일반화'를 목표로 하는 것이 아니라 '이전 가능성'을 목표로 한다는 것을 알게 되었습니다. 때문에 많은 모수가 필요하지 않습니다. 많은 모수가 필요하지 않기 때문에 아직 데이터를 수집할 수 없는 초기 스타트업이나, 혹은 특정 유저 그룹을 타겟으로 하는 서비스에 적합하다는 것을 알게 되었습니다.
결과의 이전 가능성 : 특정 연구에서 얻은 인사이트를 유사한 유저 그룹에도 적용할 수 있음을 의미한다. p.91
추가로 리서치를 해봤는데, 정성 연구에서의 적정 참여자 수에 대해서는 Guest, Bunce & Johnson(2006)의 실증 연구가 참고할 만합니다. 이들은 60건의 심층 인터뷰를 분석하면서, 인터뷰 내용을 주제별로 분류하는 태그 목록(코드북)을 만들어갔습니다. 그 결과, 6명쯤 인터뷰하면 핵심적인 큰 주제들은 대부분 나타났고, 12명을 넘어가자 새로운 주제가 거의 추가되지 않았다고 합니다. 즉, 비슷한 특징을 가진 집단이라면 생각보다 적은 수의 인터뷰로도 유의미한 패턴을 발견할 수 있다는 것입니다. 이 책에서 말하는 "5명"도 같은 맥락입니다 — 비슷한 특징을 가진 집단을 잘 분류하는 것이 전제되어야 적은 수로도 이전 가능한 인사이트를 얻을 수 있습니다.
3. 정성 연구에서 집단을 분류하는 방법
위에서 정성 연구는 비슷한 특징을 가진 집단에서 5명의 유저를 선정하여 인터뷰를 진행한다고 했습니다. 그럼 이때 무엇을 기준으로 집단을 분류해야할까요? 어쩌면 비슷한 특징의 집단을 잘 분류하는 것이 정성 연구의 핵심일지도 모릅니다.
참여자 모집 과정에서 제일 먼저 고려할 점은 연구 질문과 연구 목표에 맞는 참여자 모집 기준을 명확하게 설정하는 것입니다. 즉, "누가 우리의 연구 질문에 답을 줄 수 있을까?"를 고려해야 합니다. p.91-92
가장 먼저 연구의 질문과 목적을 명확하게 해야한다고 합니다. 예를 들어서 저희 회사에서는 이번 한 해 동안 '유저와 클럽을 잘 매칭할 수 있게 도와달라'는 목표를 가지고 있습니다. 이 상황에서 연구를 시작한다면, 그 목적은 '유저는 클럽을 잘 못찾는가?', '유저는 왜 클럽을 잘 못찾는가?'가 될 것입니다. 그러면 이 질문에 답해줄 수 있는 사람들을 선별해야합니다.
우선, 이미 트레바리 웹사이트에 익숙해져서 이 사이트의 방법대로 클럽을 잘 찾고 있는 사람들은 연구 대상에서 제외해야합니다. 처음 트레바리를 접한 유저들이 클럽을 잘 찾지 못하는 것이 문제이기 때문입니다.
또한 여기서 한번 더 집단을 분류할 수 있습니다. 저희 회사는 최근 '어디서든 트레바리'라고 전국에서 트레바리를 할 수 있도록 프로젝트를 진행중입니다. 주로 강남/안국에서 진행하던 트레바리를 전국으로 확장하게 되면서 서울이 아닌 지역의 사람들도 자신의 지역에 해당하는 클럽을 잘 찾을 수 있는지를 확인해야합니다.
여기서 기준이 두 가지 생깁니다. 하나는 경험 기준(트레바리를 처음 접했는가), 다른 하나는 지역 기준(어디에 거주하는가)입니다. 이 두 기준을 조합하면 다음과 같이 인터뷰 집단을 구성할 수 있습니다.
- 그룹 A: 트레바리에 처음 방문한 + 서울 외 지역 거주 유저
- 그룹 B: 트레바리에 처음 방문한 + 서울(강남/안국 접근 용이) 거주 유저
그룹 A에서 5명, 그룹 B에서 5명을 인터뷰한다면, 각 그룹 안에서 유사한 패턴이 나타나는지 확인할 수 있습니다. 그리고 그 패턴이 확인된다면, 같은 특징을 가진 나머지 유저들에게도 이전 가능한 인사이트가 됩니다.
4. 정성적 리서치는 어떻게 진행할까?
정성 연구에는 여러 가지 방법이 있습니다. 이 책에서 소개하는 대표적인 4가지 방법론을 간략하게 정리해봤습니다.
심층 인터뷰 — 참여자와 1:1로 깊은 대화를 나누는 방법입니다. "왜 그런 행동을 했는지", "그때 어떤 생각이었는지"처럼 행동 뒤에 숨어있는 생각과 맥락을 파악할 수 있습니다.
사용성 테스트 — 참여자에게 실제 과업을 주고 수행하는 과정을 관찰하는 방법입니다. "이 사이트에서 원하는 클럽을 찾아보세요"처럼 구체적인 목표를 주고, 어디서 막히는지, 어디서 헤매는지를 직접 볼 수 있습니다.
설문조사 — 다수의 참여자에게 동일한 질문을 던져 응답을 수집하는 방법입니다. 정량적으로도 활용되지만, 개방형 질문을 통해 정성적 데이터를 얻을 수도 있습니다. 이미 어느 정도 가설이 있을 때, 그 가설을 넓은 범위에서 확인하는 데 적합합니다.
에스노그라피 — 참여자의 실제 환경에 들어가 행동을 관찰하는 방법입니다. 인터뷰나 테스트에서는 드러나지 않는, 자연스러운 맥락에서의 행동을 파악할 수 있습니다.
우리의 질문에 어떻게 적용할 수 있을까?
저희 앞서 말씀드렸듯이 현재 저희 회사가 가지고 있는 연구 질문은 두 가지입니다.(연구라고 하니까 어색하네요ㅎㅎ) "유저는 클럽을 잘 못 찾는가?"와 "유저는 왜 클럽을 잘 못 찾는가?"입니다.
첫 번째 질문, "잘 못 찾는가?"는 현상을 확인하는 질문입니다. 이 질문에는 사용성 테스트가 가장 잘 어울립니다. 신규 유저에게 "본인에게 맞는 클럽을 찾아보세요"라는 과업을 주고, 실제로 어디서 막히는지를 관찰하면 됩니다. 필터에서 헤매는지, 스크롤을 끝까지 내리지 않는지, 클럽 상세 페이지를 제대로 확인하는지 등을 직접 볼 수 습니다.
두 번째 질문, "왜 못 찾는가?"는 원인을 탐색하는 질문입니다. 이 질문에는 심층 인터뷰가 적합합니다. "클럽을 고를 때 어떤 기준으로 보셨어요?", "처음 사이트에 왔을 때 어떤 느낌이었어요?" 같은 질문을 통해 행동 뒤에 있는 기대, 혼란, 판단 기준을 이해할 수 있습다.
가장 효과적인 방법은 이 두 가지를 결합하는 것이라고 생각합니다. 사용성 테스트로 먼저 어디서 막히는지를 관찰한 다음, 바로 이어서 "방금 여기서 멈추셨는데, 그때 어떤 생각이셨어요?"라고 물어보는 것입니다. 이렇게 하면 "어디서"와 "왜"를 한 세션에서 모두 파악할 수 있습니다.
5. 연구 결과를 어떻게 정리할까?
리서치를 진행했다면, 그 결과를 정리하는 것도 중요합니다. 이 책에서는 리서치 브리프라는 문서를 통해 연구의 배경, 목적, 방법론, 일정 등을 체계적으로 정리하라고 합니다. 리서치 브리프는 연구에 직접 참여하지 않는 이해관계자에게 연구의 필요성을 설명하고, 연구 결과가 제품 개발의 어느 부분에 영향을 줄지를 미리 소통하는 역할을 합니다. 리서치 브리프의 구체적인 작성법이 궁금하시다면 NNGroup의 Research Plan 가이드를 참고하시면 좋습니다.
Finding과 Insight를 구분하기
연구 결과를 정리할 때, 저는 이 책에서 Finding(연구 결과)과 Insight(인사이트)를 구분하는 부분이 가장 인상 깊었습니다.
"질문에 대한 답을 정리한 것이 연구 결과입니다. 하지만 인사이트는 이 결과가 왜 나왔고, 왜 중요한지를 설명하는 것입니다." p.129
"인사이트에는 '왜?(why)'와 '그래서 어떻게?(so what?)'가 포함됩니다. 매우 촘촘하게 '왜?'를 설명함으로써 설득력을 높이고 '그래서 어떻게?'를 설명함으로써 행동력을 높이는 것이죠. 인사이트를 도출하기 위해서는 단순 연구 결과 이외에 리서처의 배경지식을 깊이 활용해야 합니다." p.131
처음에는 이 둘의 차이가 와닿지 않았습니다. 하나의 예시를 들어보겠습니다.
어떤 아파트 검색 플랫폼에서 사용자 리서치를 진행했다고 가정해봅시다.
- Finding: "많은 매물 게시글에 사진이 부족하거나 품질이 낮아서, 사용자들은 실제 아파트가 어떻게 생겼는지 감을 잡기 어려웠다."
- Insight: "사용자는 제한된 시각 정보 때문에 '좋은 집을 놓칠 수 있다'는 불안감을 느낀다. 풀타임 근무로 하나하나 꼼꼼히 확인할 시간도 부족하기 때문에, 결국 비용이 더 들더라도 부동산 중개인에게 의뢰하는 쪽으로 이탈한다. → 사진의 최소 기준을 설정하거나, 사진 품질/수량 기반으로 필터링을 제공해야 한다."
Finding은 "무엇이 관찰되었는가"에 대한 답이고, Insight는 거기에 "왜 그런가"와 "그래서 어떻게 해야 하는가"를 붙인 것입니다.
저는 이 구분이 중요하다고 느꼈습니다. Finding만으로는 팀에 공유해도 "그래서 뭘 해야 하는데?"라는 질문이 남습니다. 하지만 Insight까지 도출하면 바로 다음 행동으로 연결됩니다. 정성 연구의 가치는 결국 이 Insight에 있다고 생각합니다.
책을 읽기 전 저희 OX(Online Experience)팀이 당면한 과제는 '유저들이 클럽을 잘 찾을 수 있게 해달라'는 것이었습니다. 여기서 더 정확한 문제 정의를 위해 고민하다가 정성적 리서치 방법론을 찾아보게 되었습니다.
이 책을 읽기 전에는 정성적 데이터에 대해 막연한 불신이 있었습니다. "고작 다섯 명이 한 말을 어떻게 믿어?"라는 생각이었죠. 하지만 읽고 나니, 정성 연구는 '많은 수'가 아니라 '올바른 질문'과 '올바른 집단 분류'로 신뢰를 만드는 방법이라는 것을 알게 되었습니다.
사실 아직 남아있는 의문도 있습니다. 정성적 리서치를 통해 알게 된 인사이트를 적용해서 무언가를 개선했다고 합시다. 그 개선의 결과는 어떻게 측정할 수 있을까요? 정량적 데이터를 근거로 할 때는 늘 수치가 개선되었는지 확인하는 것이 가능했습니다. 하지만 정성적 리서치의 성과는 어떻게 확인해야 할까요? 이 질문은 아직 저에게 숙제로 남아있습니다.